这是我学习最优运输(Optimal Transport, OT)时整理的笔记,主要参考 Peyré & Cuturi 的 Computational Optimal Transport 和 Cuturi 2013 年的 Sinkhorn 论文,文中的图也大多出自这两处。
1. 最优运输问题简述
给定一个源分布和一个目标分布,我们希望用最小的总代价把源分布”搬运”成目标分布。其中 \(c(m,n)\) 是把单位质量从 \(m\) 运到 \(n\) 的代价,要求的是最优的运输方案 \(p(m,n)\)。
求出最小总代价和最优运输方案之后,我们就可以:
- 用最小总代价来衡量两个分布之间的相似性或差异性;
- 在一定条件下,用运输方案 \(p(m,n)\) 对新的样本做类似的迁移。
2. 概念引入
2.1 基础概念
Histograms(概率向量 / 概率直方图):一个长度为 \(n\) 的数组,每个元素都在 \([0, 1]\) 之间,且总和为 1,即表示一个离散的概率分布:
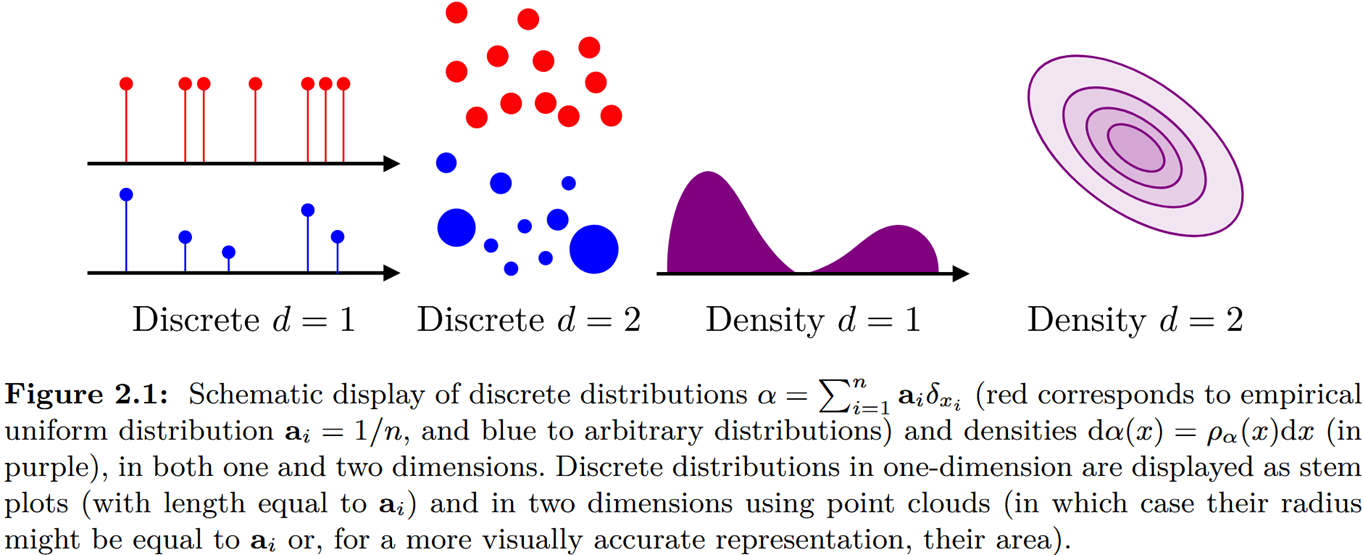
\[\Sigma_n \overset{\text{def.}}{=} \left\{ \mathbf{a} \in \mathbb{R}_{+}^n : \sum_{i=1}^n \mathbf{a}_i = 1 \right\}\]Discrete measures(离散测度):一个带有权重 \(\mathbf{a}\)、位置为 \(x_1, \ldots, x_n \in \mathcal{X}\) 的离散测度写作
\[\alpha=\sum_{i=1}^n \mathbf{a}_i \delta_{x_i}\]下图中红色点是均匀分布(\(\mathbf{a}_i = 1/n\)),蓝色点是任意分布。一维的离散分布画成竖线(长度即权重),二维的离散分布画成点云(点的大小表示权重)。
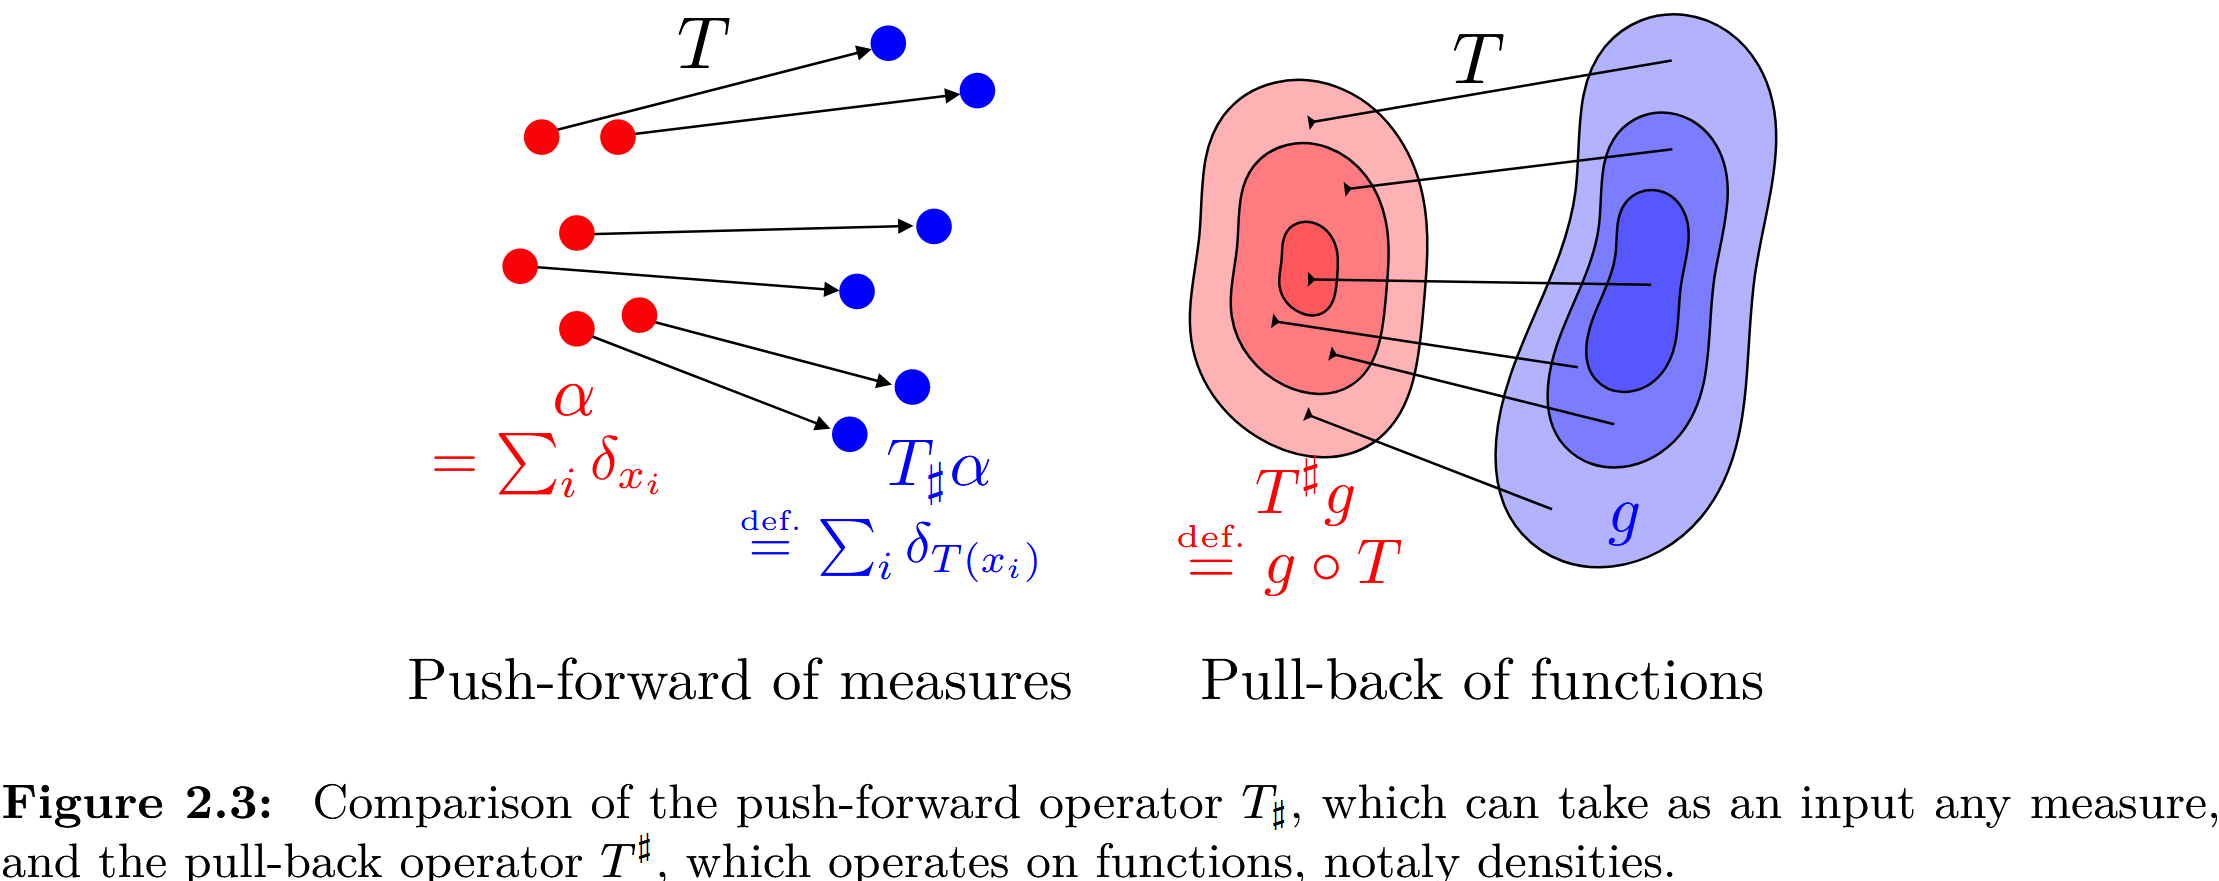
Push-forward operator(前推算子):对于连续映射 \(T:\mathcal{X}\to\mathcal{Y}\),定义前推算子 \(T_\sharp:\mathcal{M}(\mathcal{X})\to\mathcal{M}(\mathcal{Y})\)。对于离散测度,前推算子就是把测度中每个点的位置都用 \(T\) 移动一下:
\[T_\sharp\alpha\overset{\text{def.}}{=}\sum_i\mathbf{a}_i\delta_{T(x_i)}\]直观地说,可测映射 \(T\) 把一个空间中的点移动到另一个空间中的点,而 \(T_\sharp\) 是它的扩展:作用对象从单个点变成了整个概率测度,把一个测度整体”推”成一个新的测度。
2.2 蒙日(Monge)问题
2.2.1 定义
Monge 问题:找一个从一个测度到另一个测度的映射,使得所有 \(c(x_i, T(x_i))\) 的和最小。其中 \(c\) 表示运输代价,需要根据具体应用来定义。
用离散测度来说,对于两个离散测度
\[\alpha=\sum_{i=1}^n \mathbf{a}_i \delta_{x_i} \quad \text{and} \quad \beta=\sum_{j=1}^m \mathbf{b}_j \delta_{y_j}\]我们要找一个映射 \(T:\{x_1,\ldots,x_n\}\to\{y_1,\ldots,y_m\}\),使得
\[\forall j \in [\![ m ]\!], \quad \mathbf{b}_j=\sum_{i: T(x_i)=y_j} \mathbf{a}_i\]这个约束可以简写为 \(T_{\sharp} \alpha=\beta\),称为质量守恒约束(mass conservation constraint)。
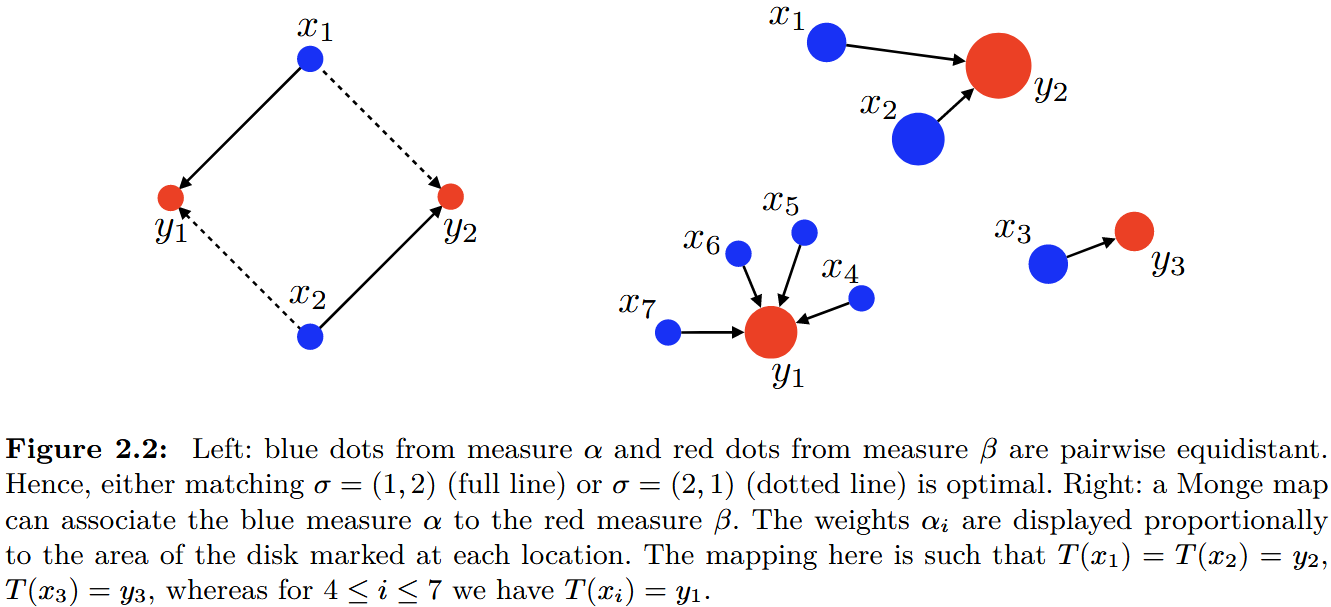
- \(n=m\) 且权重均匀时,\(T\) 就是一个一一对应的匹配,如下左图;
- \(n>m\) 时,一个 \(x_i\) 只能整体送到一个 \(y_j\),但一个 \(y_j\) 可以接收多个 \(x_i\),如下右图;
- \(n<m\) 时(且 \(\mathbf{b}_j\) 都大于 0),最多只有 \(n\) 个 \(y_j\) 能收到质量,约束无法满足,问题无解。
最终的形式化表达为
\[\min_T\left\{\sum_i c\left(x_i, T\left(x_i\right)\right): T_{\sharp} \alpha=\beta\right\}\]含义是:通过映射 \(T\),所有 \(\mathbf{a}_i\) 都必须被运走,并且每个 \(\mathbf{b}_j\) 收到的总量恰好等于它自己。其中 \(c\) 代表运输代价,\(T\) 就是运输方案。
2.2.2 缺陷
- 不一定存在可行解:例如上面说的 \(n<m\) 的情况。
- 可行域非凸,求解效率低:质量守恒约束里的 push-forward 是一个组合约束,使得优化非常困难,很多时候只能枚举方案,复杂度极高。
那么能否去掉 push-forward 这种”确定性映射”的约束,把整个 OT 问题变成凸问题?这样一来:
- 可行解总是存在(例如 \(\mathbf{a}\mathbf{b}^{\mathrm{T}}\));
- 可以灵活地使用各种优化方法求解。
这就是 Kantorovich 松弛。
2.3 Kantorovich 松弛
2.3.1 运输多面体
Kantorovich 的关键想法是放宽运输的”确定性”:在 Monge 问题里,源点 \(x_i\) 只能整体分配给一个位置 \(T(x_i)\);而 Kantorovich 允许 \(x_i\) 的质量被拆分,分别送往多个目标点。也就是说,他放弃了确定性运输,转而考虑概率运输(probabilistic transport)。
对于概率向量 \(\mathbf{a}\in\Sigma_n\) 和 \(\mathbf{b}\in\Sigma_m\),可行的运输方案(耦合)集合定义为
\[\mathbf{U}(\mathbf{a}, \mathbf{b}) \stackrel{\text{def.}}{=}\left\{\mathbf{P} \in \mathbb{R}_{+}^{n \times m}: \mathbf{P} \mathbf{1}_m=\mathbf{a} \quad \text{and} \quad \mathbf{P}^{\mathrm{T}} \mathbf{1}_n=\mathbf{b}\right\}\]其中
\[\mathbf{P} \mathbf{1}_m=\Big(\sum_j \mathbf{P}_{i, j}\Big)_i \in \mathbb{R}^n \quad \text{and} \quad \mathbf{P}^{\mathrm{T}} \mathbf{1}_n=\Big(\sum_i \mathbf{P}_{i, j}\Big)_j \in \mathbb{R}^m\]即 \(\mathbf{P}\) 的行和等于 \(\mathbf{a}\),列和等于 \(\mathbf{b}\)。下图右侧把一个离散耦合画成矩阵,黑点的大小表示 \(\mathbf{P}_{i,j}\):
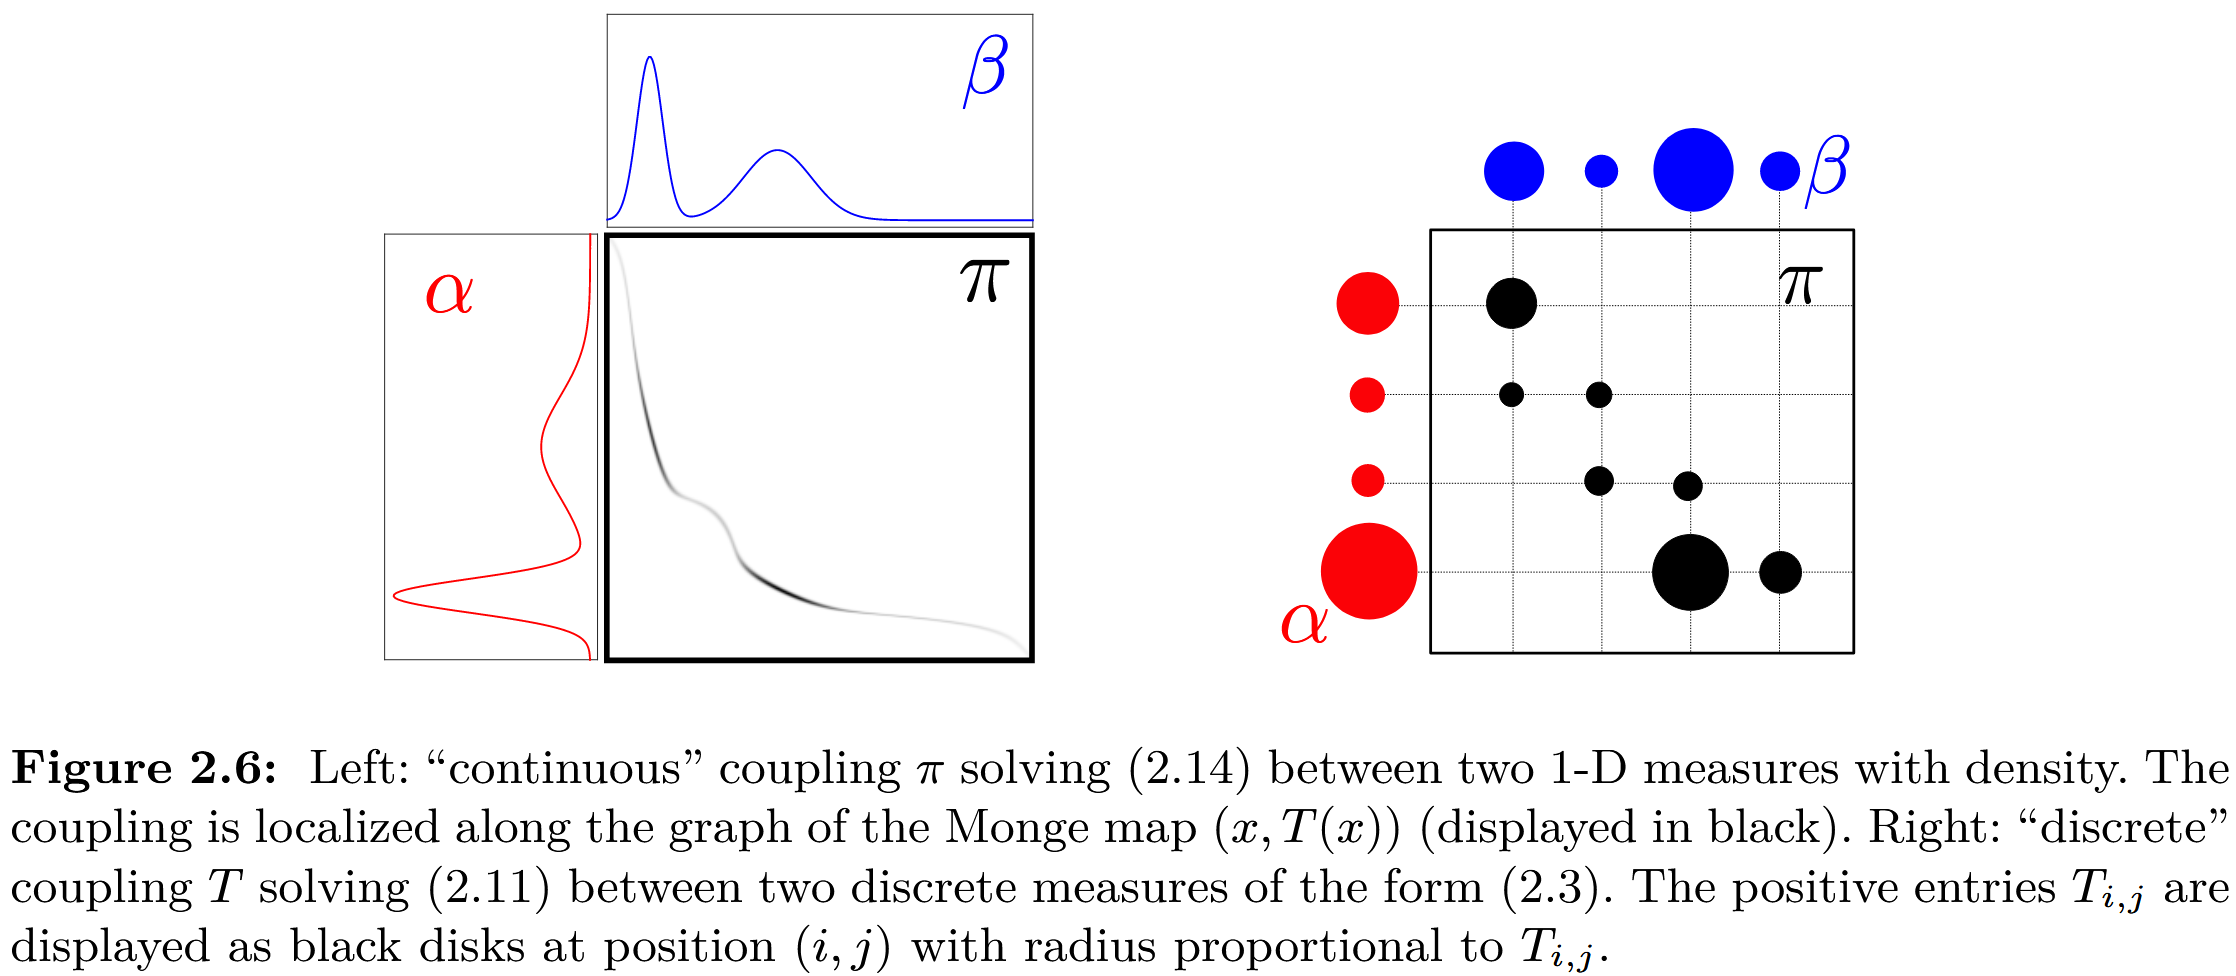
\(\mathbf{U}(\mathbf{a},\mathbf{b})\) 由 \(n+m\) 个线性等式约束加上非负约束定义,是一个有界的凸多面体(有限个矩阵的凸包)。
此外,Monge 问题本质上是不对称的(见上面 Monge 例子的右图:\(x\) 可以合并到 \(y\),但反过来 \(y_1\) 无法拆回 \(x_4,\ldots,x_7\)),而 Kantorovich 松弛总是对称的:\(\mathbf{P}\in\mathbf{U}(\mathbf{a},\mathbf{b})\) 当且仅当 \(\mathbf{P}^{\mathrm{T}}\in\mathbf{U}(\mathbf{b},\mathbf{a})\)。
2.3.2 求解公式与理解
最终的优化问题为
\[\mathrm{L}_{\mathbf{C}}(\mathbf{a}, \mathbf{b}) \stackrel{\text{def.}}{=} \min_{\mathbf{P} \in \mathbf{U}(\mathbf{a}, \mathbf{b})}\langle\mathbf{C}, \mathbf{P}\rangle \stackrel{\text{def.}}{=} \sum_{i, j} \mathbf{C}_{i, j} \mathbf{P}_{i, j}\]对这个式子的理解:
- \(\mathbf{C}\) 与 \(\mathbf{P}\) 的矩阵内积要尽可能小,即运输代价越小的两个点,获得越大的匹配权重 \(\mathbf{P}_{i,j}\);
- Kantorovich 松弛了约束,允许多个 \(x\) 到多个 \(y\) 的匹配;
- \(\mathbf{P}^*\) 的行和等于 \(\mathbf{a}\),列和等于 \(\mathbf{b}\),即输入与输出的总量要匹配;
- 因为 \(\mathbf{P}^*\) 的行和、列和分别是两个概率分布,\(\mathbf{P}^*\) 也可以理解为一个联合概率分布矩阵。
2.3.3 对比 Monge 与 Kantorovich
- 动机:Kantorovich 松弛了 Monge 问题的质量守恒约束,引入 mass splitting,即源点 \(x_i\) 的质量可以分散地运到不同地方;
- 思想:从确定性运输(deterministic transport)变成概率运输(probabilistic transport);
- 求解:Monge 问题非凸,且不一定有可行解;Kantorovich 问题是一个线性规划,一定存在最优解,并且可以用成熟的线性规划方法求解;
- 泛化性:Kantorovich 形式极大地扩展了 OT 的应用场景。
3. 算法求解
3.1 精确求解
最优运输问题的求解一般指求 Kantorovich 松弛的解,它是一个线性规划。
3.1.1 运输多面体的顶点
可行集非空且有界的线性规划,一定能在可行集的某个顶点处取到最小值。由于 \(\mathbf{U}(\mathbf{a},\mathbf{b})\) 是有界的,可以把最优 \(\mathbf{P}\) 的搜索范围限制在多面体 \(\mathbf{U}(\mathbf{a},\mathbf{b})\) 的顶点(极值点)上。
3.1.2 二分图视角
可以把 OT 看成二分图上的网络流问题:左边是 \(n\) 个源点,右边是 \(m\) 个目标点,每条边 \((i, j')\) 的代价为 \(\mathbf{C}_{i,j}\),\(\mathbf{P}_{i,j}\) 就是这条边上的流量。
一个重要结论是:\(\mathbf{P}\) 是 \(\mathbf{U}(\mathbf{a},\mathbf{b})\) 的顶点,当且仅当它的非零流量边不构成环。这也意味着顶点解中最多只有 \(n+m-1\) 条非零流量。
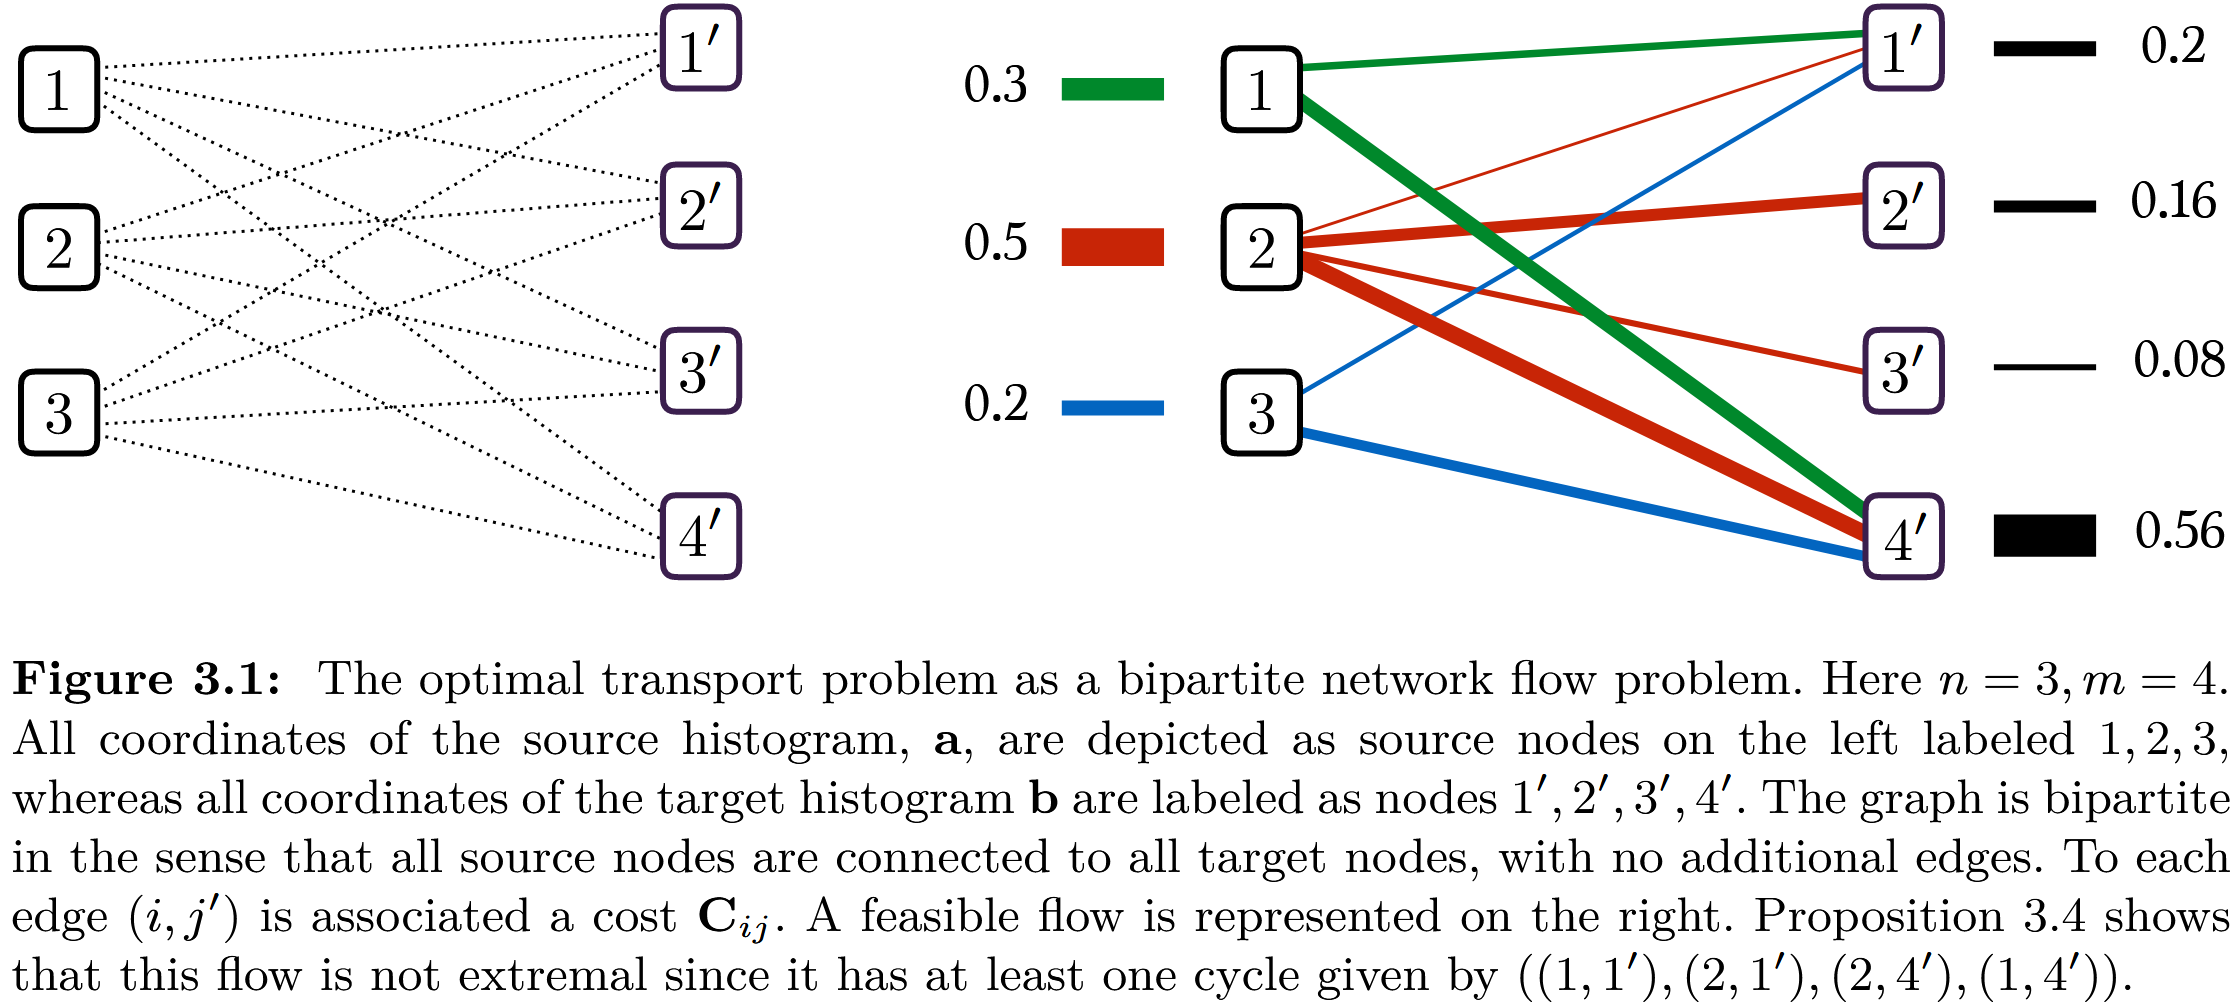
上图右侧的每条连线表示一条质量流,其中存在环 \((1,1'),(2,1'),(2,4'),(1,4')\),所以它不是一个顶点。这就是最优运输问题的几何解释。
3.1.3 西北角法与网络单纯形法
- 西北角法(North-west corner rule):从矩阵左上角开始,每次在当前位置放入”剩余的 \(\mathbf{a}_i\)“和”剩余的 \(\mathbf{b}_j\)“中较小的那个,哪边先用完就向下或向右移动一格。最多 \(n+m-1\) 步就能得到一个顶点解,它是可行的,但通常不是最优的。
- 网络单纯形法(Network simplex):以西北角法的结果为初始解,每次加入一条能降低总代价的边,并沿着产生的环调整流量,在相邻顶点之间移动,直到找不到更优的顶点为止。
精确求解在 \(n\) 个点时的复杂度大约是 \(O(n^3\log n)\) 量级,数据量一大就很慢,这也是后面要引入熵正则化的原因。
3.2 熵(Entropic)正则化
在大部分应用中,求出 Kantorovich 问题的精确解是不必要的:如果改用正则化求近似解,最优运输的计算代价会大幅降低。熵的定义为
\[\mathbf{H}(\mathbf{P}) \stackrel{\text{def.}}{=}-\sum_{i, j} \mathbf{P}_{i, j}\left(\log \mathbf{P}_{i, j}-1\right)\]\(\mathbf{H}\) 是 1-强凹(strongly concave)的,因为 \(\partial^2 \mathbf{H}(\mathbf{P})=-\operatorname{diag}\left(1 / \mathbf{P}_{i, j}\right)\) 且 \(\mathbf{P}_{i, j} \leq 1\)。熵正则化就是用 \(-\mathbf{H}\) 作为正则项,求一个近似解:
\[\mathrm{L}_{\mathbf{C}}^{\varepsilon}(\mathbf{a},\mathbf{b}) \stackrel{\text{def.}}{=} \min_{\mathbf{P} \in \mathbf{U}(\mathbf{a},\mathbf{b})}\langle \mathbf{P},\mathbf{C}\rangle - \varepsilon \mathbf{H}(\mathbf{P})\]下图展示了 \(\varepsilon\) 的影响:\(\varepsilon = 0\) 时解落在可行域的顶点上(即 LP 的解);随着 \(\varepsilon\) 增大,熵把解逐渐推离边界,移向可行域内部的”熵中心”。
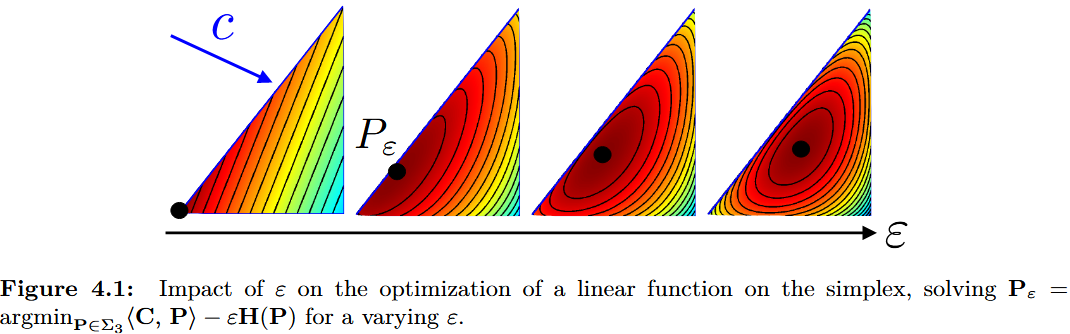
从耦合矩阵上看,熵正则化惩罚由少数几条大流量路径组成的稀疏方案,鼓励把质量分散到许多小流量路径上。\(\varepsilon\) 越大,耦合越模糊、越分散(\(\varepsilon\to\infty\) 时趋向 \(\mathbf{a}\mathbf{b}^{\mathrm{T}}\));\(\varepsilon\) 越小,越接近稀疏的精确解。
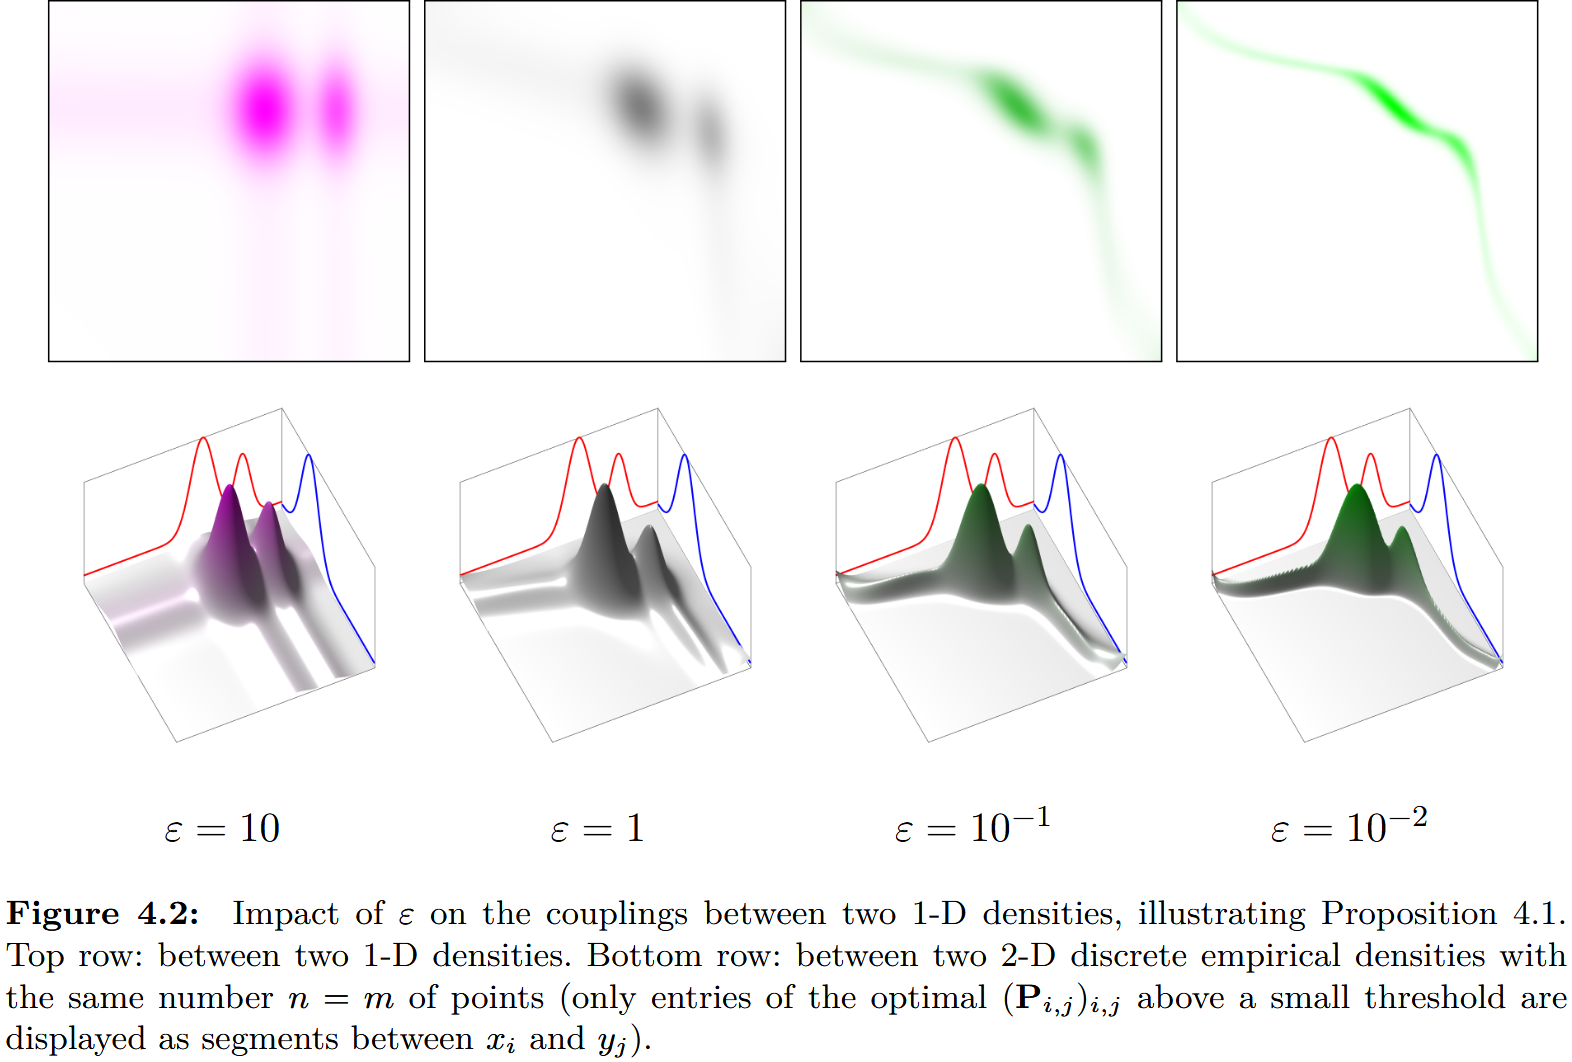
加了熵之后,目标函数变成强凸的,最优解有非常简单的结构,可以用下一节的 Sinkhorn 迭代快速求解,这就是熵正则化能大幅降低计算代价的原因。
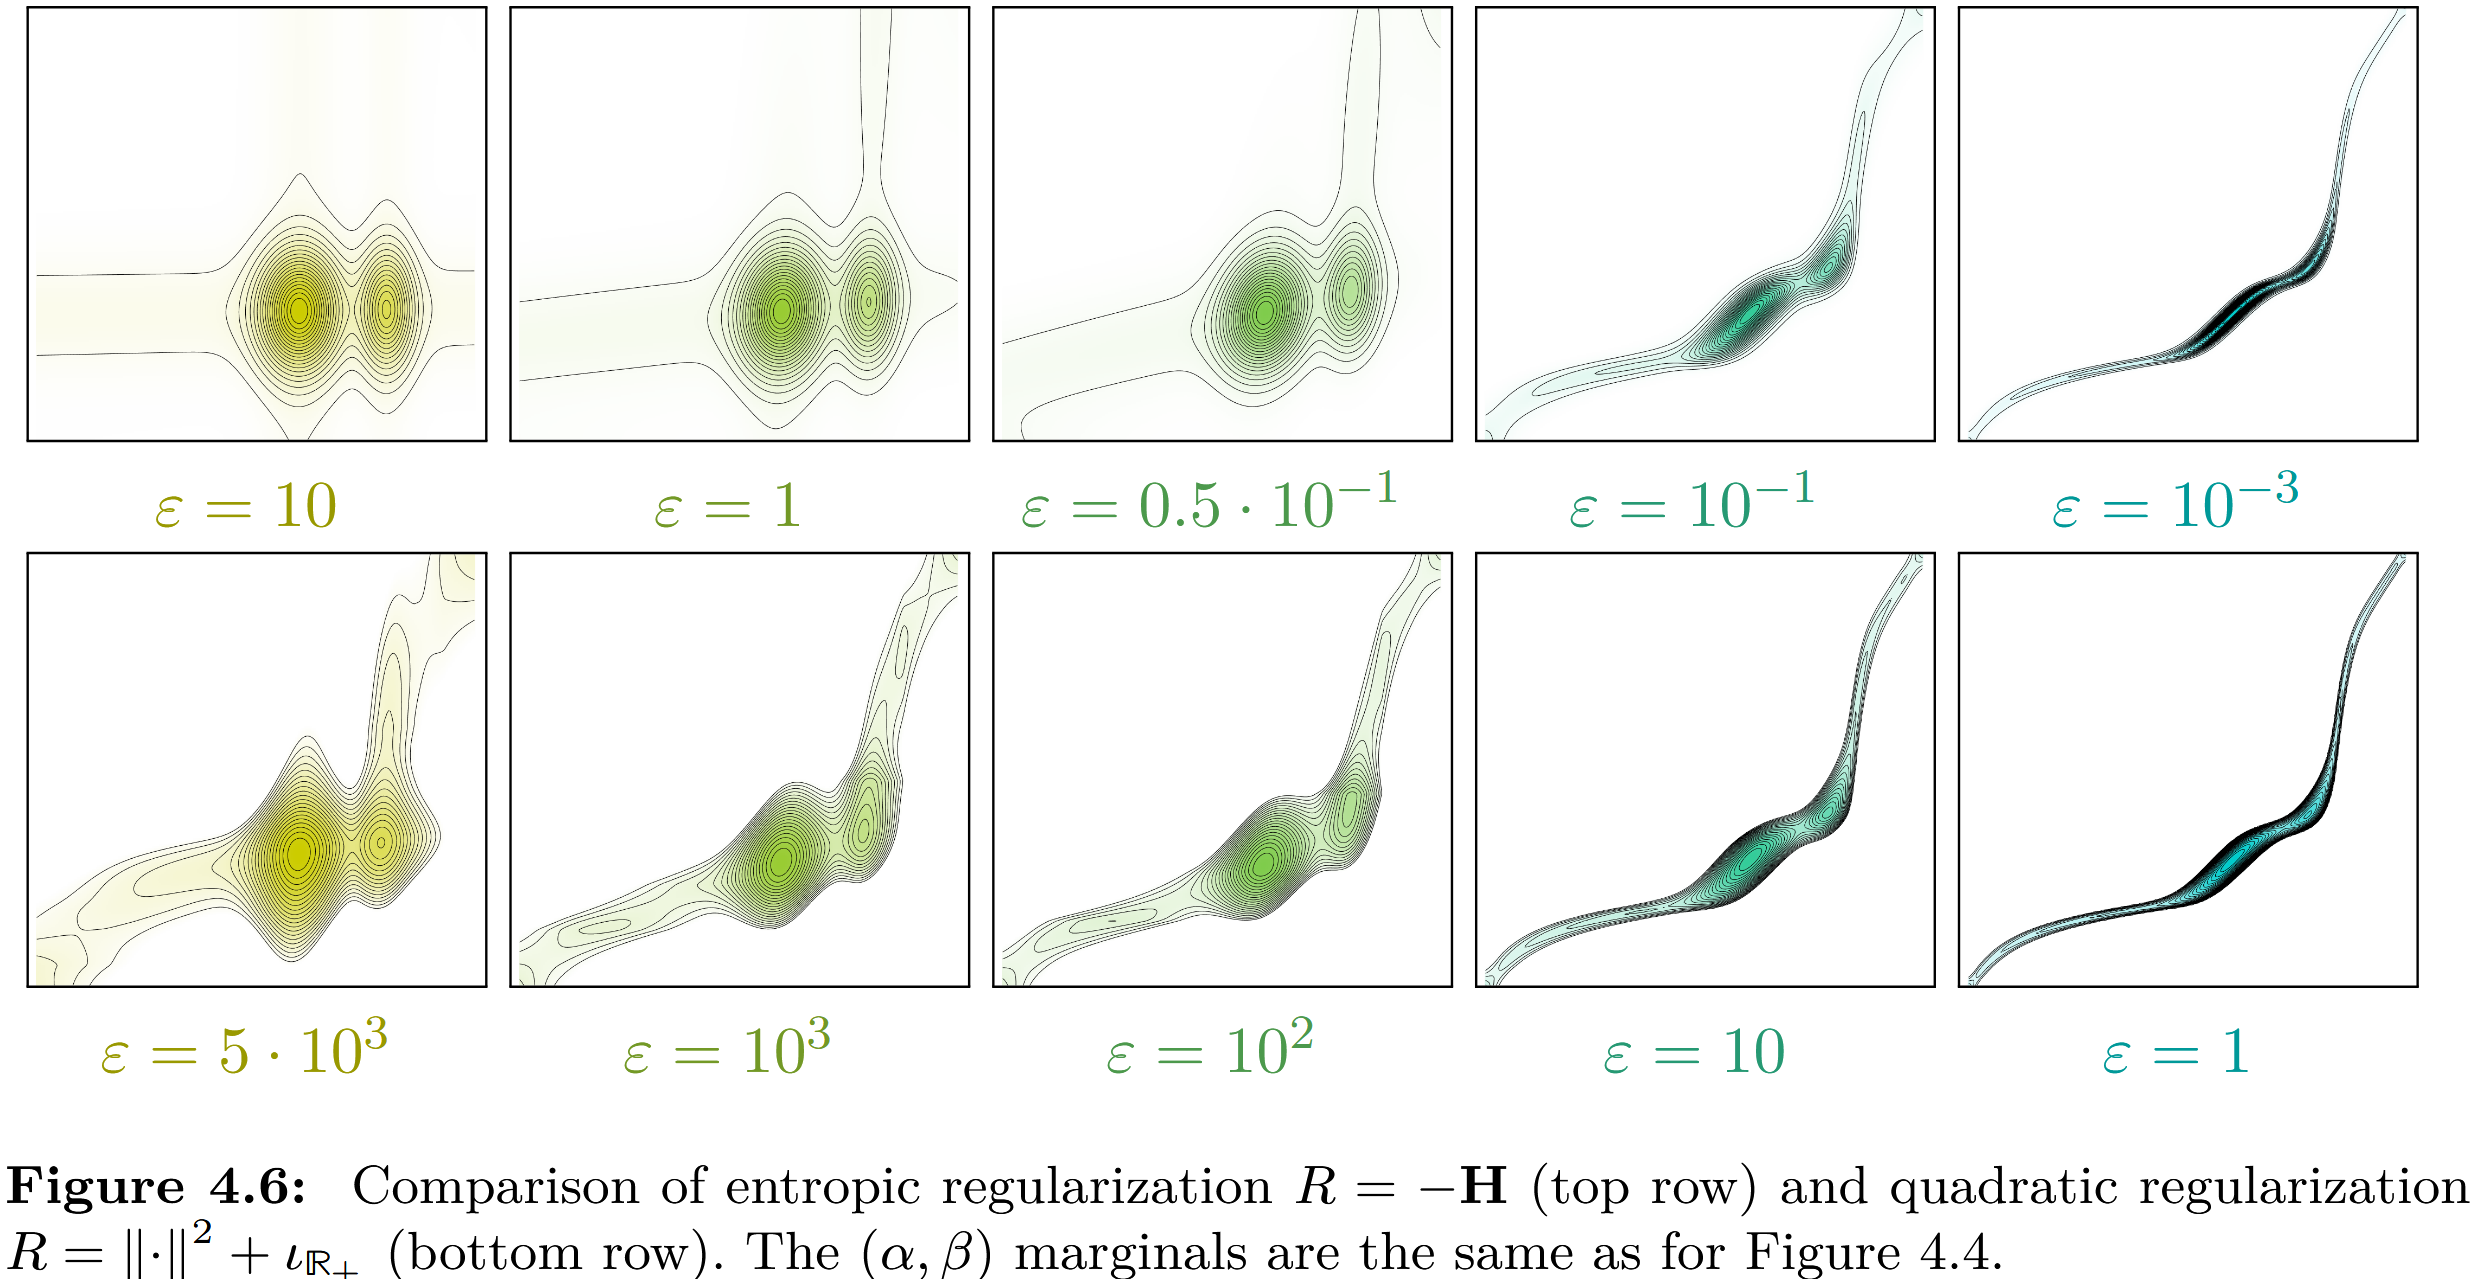
补充:二次正则化。 除了熵,也可以用二次项 \(\|\mathbf{P}\|^2\) 做正则。和熵相比,它的主要优点是得到的最优耦合是稀疏的近似,但代价是求解更慢,也不能像 Sinkhorn 那样高效地并行、同时计算多个最优运输问题。下图上面一行是熵正则化,下面一行是二次正则化:
3.3 Sinkhorn 算法
Sinkhorn 算法正是求解上面熵正则化问题的方法:可以证明最优解一定具有 \(\operatorname{diag}(u)\,K\,\operatorname{diag}(v)\) 的形式,只需要交替缩放两个向量 \(u\) 和 \(v\),让行和、列和分别等于两个边缘分布即可。得到 \(u\) 和 \(v\),就得到了正则化问题的最优耦合,它是原问题的一个近似解。下面沿着 Cuturi (2013) 的思路推导一遍。
3.3.1 符号整理
\(r\) 与 \(c\) 是两个概率向量,属于单纯形 \(\Sigma_d:=\{x\in \mathbb{R}_{+}^{d}: x^{\mathrm{T}}\mathbf{1}_d=1\}\)。运输多面体(transport polytope)为
\[U(r, c) \stackrel{\text{def.}}{=}\left\{P \in \mathbb{R}_{+}^{d \times d}: P \mathbf{1}_d=r \quad \text{and} \quad P^{\mathrm{T}} \mathbf{1}_d=c\right\}\]\(P\) 可以理解为联合概率分布,它的两个边缘分布分别是 \(r\) 与 \(c\)。\(M\) 是代价矩阵,原文取为一个距离矩阵(对角线为 0,且满足三角不等式):
\[\mathcal{M}=\left\{M \in \mathbb{R}_{+}^{d \times d}: \forall i, j \leq d,\ m_{ij}=0 \Leftrightarrow i=j,\quad \forall i, j, k \leq d,\ m_{ij} \leq m_{ik}+m_{kj}\right\}\]优化目标为
\[d_{M}(r, c):=\min_{P \in U(r, c)}\langle P, M\rangle\]3.3.2 Sinkhorn distances
思路仍然是:想让解不那么稀疏,就要让它的熵更大。在 \(U(r,c)\) 中熵最大的是独立耦合 \(rc^{\mathrm{T}}\):它的每个元素是 \(r_i c_j\),只要 \(r\)、\(c\) 严格为正就全都大于 0,是最”稠密”的运输方案。
于是加上约束,让 \(P\) 不能离 \(rc^{\mathrm{T}}\) 太远:
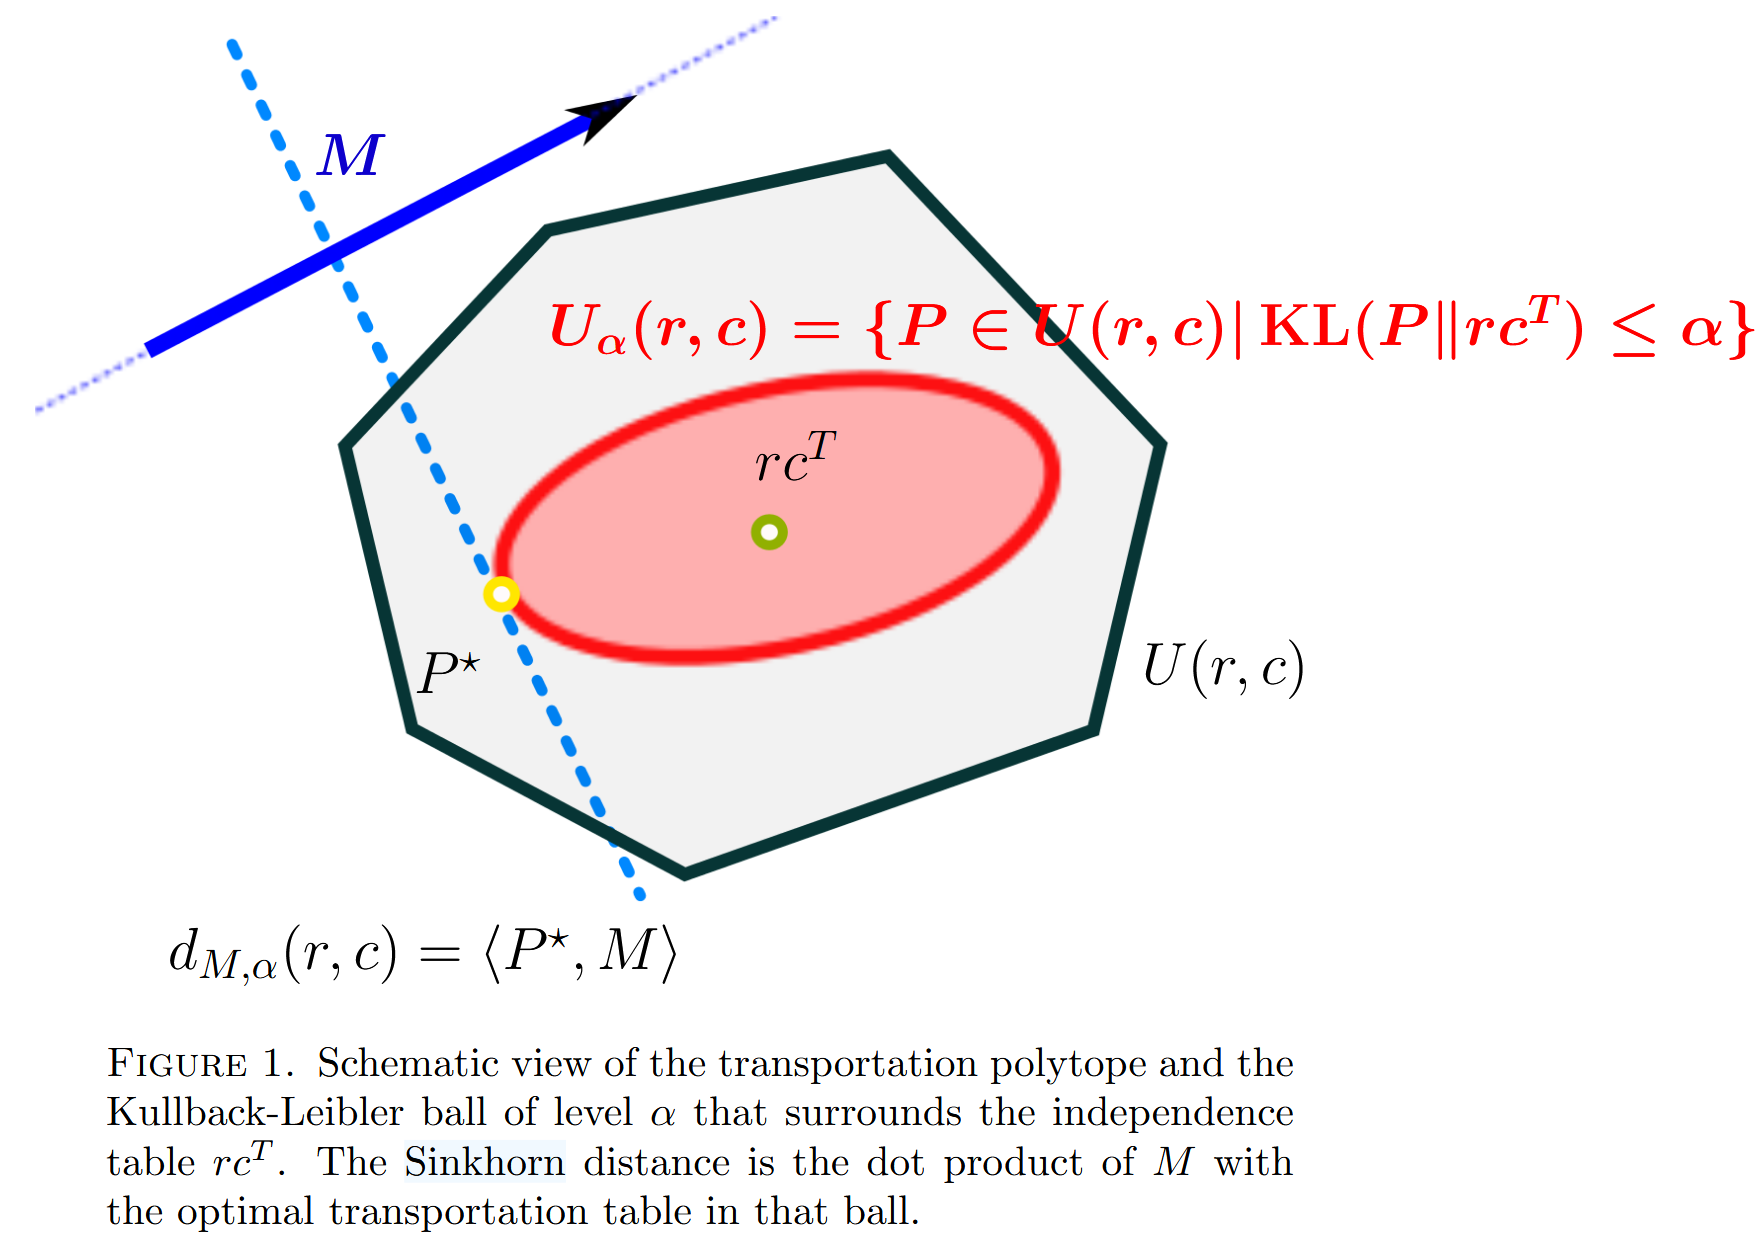
\[U_{\alpha}(r, c)=\left\{P \in U(r, c) \mid \mathrm{KL}\left(P \,\|\, r c^{\mathrm{T}}\right) \leq \alpha\right\}\]并定义 Sinkhorn 距离
\[d_{M, \alpha}(r, c) \stackrel{\text{def.}}{=} \min_{P \in U_{\alpha}(r, c)}\langle P, M\rangle\]如下图所示,Sinkhorn 距离就是 \(M\) 与这个 KL 球中最优运输方案的内积。
由信息论中的经典不等式(Cover & Thomas, 1991),联合熵不超过边缘熵之和:
\[\forall r, c \in \Sigma_{d},\ \forall P \in U(r, c), \quad h(P) \leq h(r)+h(c)\]再把 KL 散度展开,可以得到
\[U_{\alpha}(r, c)=\left\{P \in U(r, c) \mid h(P) \geq h(r)+h(c)-\alpha\right\} \subset U(r, c)\]下面证明其中用到的等式
\[\mathrm{KL}\left(P \,\|\, r c^{\mathrm{T}}\right)=h(r)+h(c)-h(P)\]KL 散度、熵和交叉熵的定义分别为
\[\mathrm{KL}(P\|Q)=\sum_i P_i\log\frac{P_i}{Q_i}, \quad h(P)=-\sum_i P_i\log P_i, \quad H(P,Q) = -\sum_i P_i\log Q_i\]并且 \(\mathrm{KL}(P\|Q)=H(P,Q)-h(P)\)。所以只需证明 \(H(P,rc^{\mathrm{T}})=h(r)+h(c)\):
\[\begin{aligned} H(P,rc^{\mathrm{T}}) &= -\sum_{i,j}p_{ij}\log(r_i c_j) \\ &= -\sum_i\Big(\sum_j p_{ij}\Big)\log r_i-\sum_j\Big(\sum_i p_{ij}\Big)\log c_j \\ &= -\sum_i r_i\log r_i-\sum_j c_j\log c_j \\ &= h(r)+h(c) \end{aligned}\]第三步用到了 \(P\) 的行和为 \(r\)、列和为 \(c\)。证毕。
回到约束 \(h(P) \geq h(r)+h(c)-\alpha\):其中 \(h(r)\) 与 \(h(c)\) 都是常数,所以约束就是 \(h(P)\) 不小于某个常数。根据拉格朗日对偶,对每个 \(\alpha\) 都存在一个 \(\lambda>0\),使得这个带约束的问题等价于最小化
\[\langle P, M\rangle-\frac{1}{\lambda} h(P)\]也就是希望 \(h(P)\) 尽可能大。它和 3.2 节的熵正则化是同一个问题(\(\lambda = 1/\varepsilon\),两者的熵只差一个常数)。
再把边缘分布的约束加上,写出拉格朗日函数:
\[L(P, \alpha, \beta)=\sum_{i,j} \Big(\frac{1}{\lambda} p_{ij} \log p_{ij}+p_{ij} m_{ij}\Big)+\alpha^{\mathrm{T}}\left(P \mathbf{1}_{d}-r\right)+\beta^{\mathrm{T}}\left(P^{\mathrm{T}} \mathbf{1}_{d}-c\right)\]对 \(p_{ij}\) 求偏导并令其为 0:
\[\begin{aligned} \frac{1}{\lambda}(\log p_{ij}+1)+m_{ij}+\alpha_{i}+\beta_{j}&=0 \\ \log p_{ij}&=-1-\lambda(m_{ij}+\alpha_{i}+\beta_{j}) \\ p_{ij}^{\lambda}&=e^{-\frac{1}{2}-\lambda \alpha_{i}}\; e^{-\lambda m_{ij}}\; e^{-\frac{1}{2}-\lambda \beta_{j}} \end{aligned}\]记 \(u_{i}=e^{-\frac{1}{2}-\lambda \alpha_{i}}\),\(v_{j}=e^{-\frac{1}{2}-\lambda \beta_{j}}\),\(K_{ij}=e^{-\lambda m_{ij}}\),写成矩阵形式就是
\[P^{\lambda}=\operatorname{diag}(u)\, K\, \operatorname{diag}(v)\]所以我们真正要解的只有 \(u\) 和 \(v\)。代入边缘分布的约束:
\[\sum_{j} p_{ij}=u_{i}\,(Kv)_{i}=r_{i}, \qquad \sum_{i} p_{ij}=v_{j}\,(K^{\mathrm{T}}u)_{j}=c_{j}\]由此得到 \(u\)、\(v\) 的迭代公式,用不动点迭代交替更新,直到收敛:
\[u_{i}^{(t+1)}=\frac{r_{i}}{\big(K v^{(t)}\big)_{i}}, \qquad v_{j}^{(t+1)}=\frac{c_{j}}{\big(K^{\mathrm{T}} u^{(t+1)}\big)_{j}}\]每一步只是一次矩阵-向量乘法加逐元素除法,很适合在 GPU 上批量计算,并且可以证明这个迭代是线性收敛的。
4. OT 的实际应用
4.1 Wasserstein GAN(ICML 2017)
用 Wasserstein-1 距离(借助 Kantorovich–Rubinstein 对偶)替代原始 GAN 中的 JS 散度作为训练目标。当两个分布的支撑集几乎不重叠时,JS 散度的梯度会消失,而 Wasserstein 距离依然能给出有意义的梯度,训练更稳定。
4.2 用最优运输做缺失值填补(ICML 2020)
结合了 Wasserstein 距离、熵正则化和 Sinkhorn 算法。核心想法是:从同一个数据集里随机抽出的两个 batch 应该来自同一个分布,所以它们之间的 Sinkhorn 散度应该很小;把缺失值当作优化变量,最小化 batch 之间的 Sinkhorn 散度,就得到了填补结果。
4.3 Neural Optimal Transport(ICLR 2023 Spotlight)
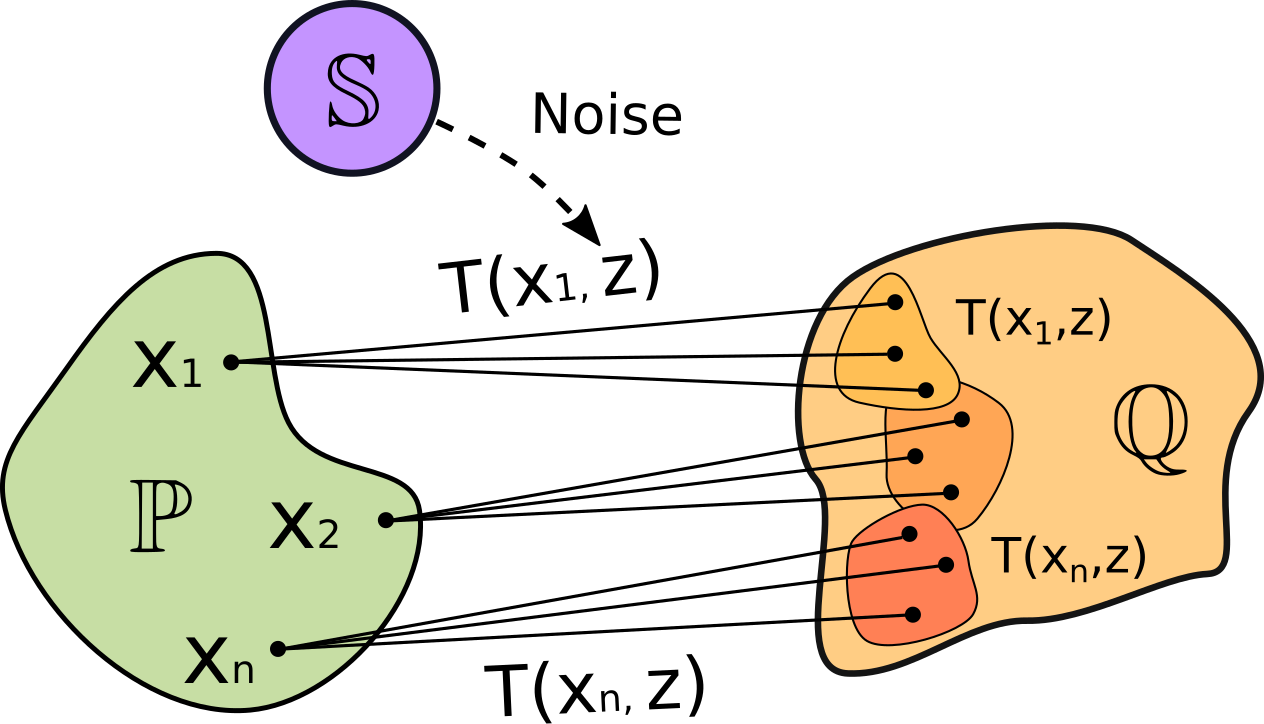
用神经网络学习一个随机的 OT 映射 \(T(x, z)\):同一个输入 \(x\) 配合不同的噪声 \(z\),可以映射到目标分布中的多个样本,从而实现一对一和一对多的迁移,并且提供参数来控制生成结果的多样性。代码见 iamalexkorotin/NeuralOptimalTransport。
参考文献
- G. Peyré, M. Cuturi. Computational Optimal Transport. Foundations and Trends in Machine Learning, 2019.
- M. Cuturi. Sinkhorn Distances: Lightspeed Computation of Optimal Transport. NeurIPS, 2013.
- T. M. Cover, J. A. Thomas. Elements of Information Theory. Wiley, 1991.
- M. Arjovsky, S. Chintala, L. Bottou. Wasserstein Generative Adversarial Networks. ICML, 2017.
- B. Muzellec, J. Josse, C. Boyer, M. Cuturi. Missing Data Imputation using Optimal Transport. ICML, 2020.
- A. Korotin, D. Selikhanovych, E. Burnaev. Neural Optimal Transport. ICLR, 2023.